메뉴 건너뛰기

Extra Form
출처 https://hcnoh.github.io/2021-04-17-dkvmn

Knowledge Tracing

Knowledge Tracing이란 주어진 문제들을 풀어가는 사용자의 수준을 파악하기 위한 학습 모델을 추정하기 위한 태스크를 말한다. 기존 고전 방법론으로는 Bayesian Network 및 확률 모델 파라미터 추정 방법론들을 활용한 Bayesian Knowledge Tracing (BKT)을 중심으로 연구가 되어왔으며, 현재는 딥러닝 기술을 활용하여 Deep Knowledge Tracing (DKT)을 중심으로 다양한 모델들에 대한 연구가 수행되고 있다.

이번 포스트에서 소개하고자 하는 논문은 딥러닝 기반의 Knowledge Tracing 모델이며 Dynamic Key-Value Memory Network (DKVMN)라고 불리우는 모델이다. 논문에서는 DKVMN의 우수성을 강조하기 위하여 추가적으로 Memory-Augmented Neural Network (MANN)도 제시하였지만 이번 포스트에서는 DKVMN만을 설명하도록 하겠다. (추후 MANN에 대한 설명을 추가할 예정)

또한 Knowledge Tracing에 대한 전반적인 문제 정의에 대해서는 링크를 참고하면 도움이 될 것이다.

문제 정의

DKVMN은 Knowledge Tracing 연구에서 (필자가 알기로는) 최초로 다양한 개념이 존재하고 그 개념들 사이에 상호작용을 통해서 사용자의 학습 활동이 수행된다는 점을 주장하였다. DKVMN에서 제시한 문제 세팅을 간단히 요약하면 아래의 그림과 같다.
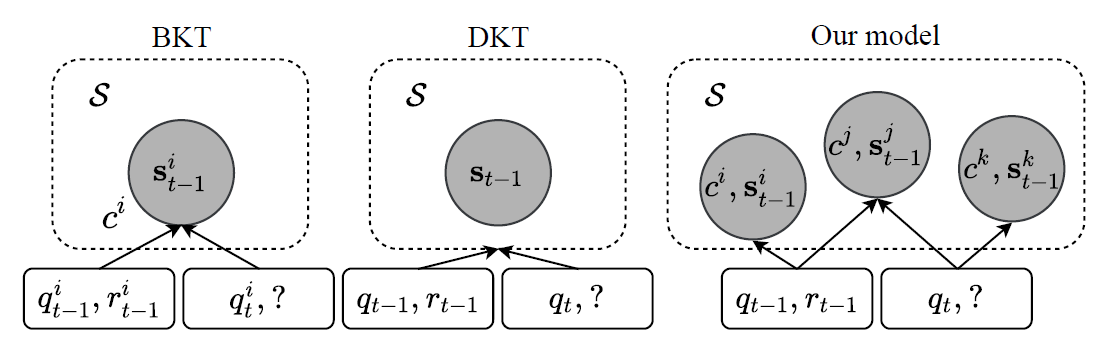
즉, BKT는 사용자와 개념들 각각마다 확률 모델을 가정하고 현상을 설명하기위한 최적의 파라미터를 추정하려고 시도한다.

DKT는 개념을 따로 가정하지는 않고 사용자에 따라 반응을 예측하는 딥러닝 모델을 활용하였고 개념은 딥러닝 상에서 숨겨진 Black Box로만 존재하여 우리가 확인할 수 없다.

하지만 DKVMN은 기존의 모델들과는 다르게 다양한 개념들이 존재하고 이들 사이에는 서로 상호작용이 가능하며 그를 통해서 사용자의 반응을 추정하는 모델을 제시한다.

여기서 중요한 점은 개념을 가정했다는 것보다도 다양한 개념들 사이의 상호작용을 상정하고 모델을 구축했다는 점을 들 수 있을것 같다.

모델 구조
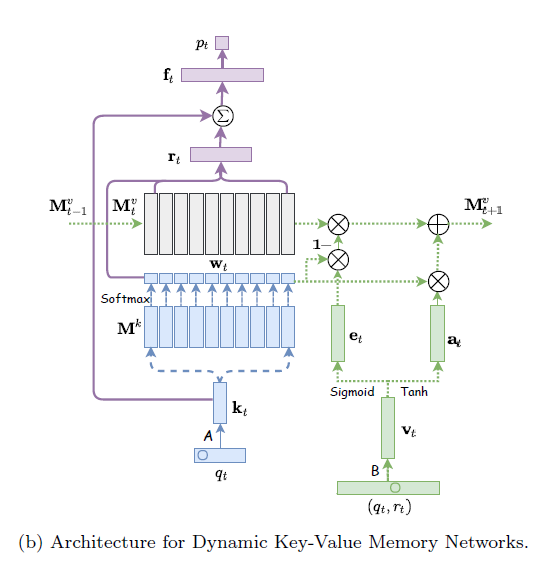
DKVMN의 모델 구조는 MANN 모델 구조에서 External Memory Matrix를 Value Matrix Mtv 및 Key Matrix Mk로 나누는 방식으로 구현하였다.

Value Matrix Mtv는 dv×N의 크기를 가지고 있으며 N개의 Latent Concept들 {c1,c2,⋯,cN} 각각에 대한 사용자의 Concept State {st1,st2,⋯,stN}을 인코딩하고 있다. 밑첨자 t가 들어있는 이유는 모델의 추론 과정에서 이 메모리 값들은 시간에 따라서 동적으로(Dynamic) 변화한다는 의미이며 이것이 DKVMN의 이름을 가지게 된 이유라고 볼 수 있다.

반면 Key Matrix Mk는 N개의 Latent Concept들 {c1,c2,⋯,cN}을 인코딩하고 있는 행렬이며 모델의 추론 과정에서 시간과 관계없이 변하지않는 Static한 메모리라고 볼 수 있다.

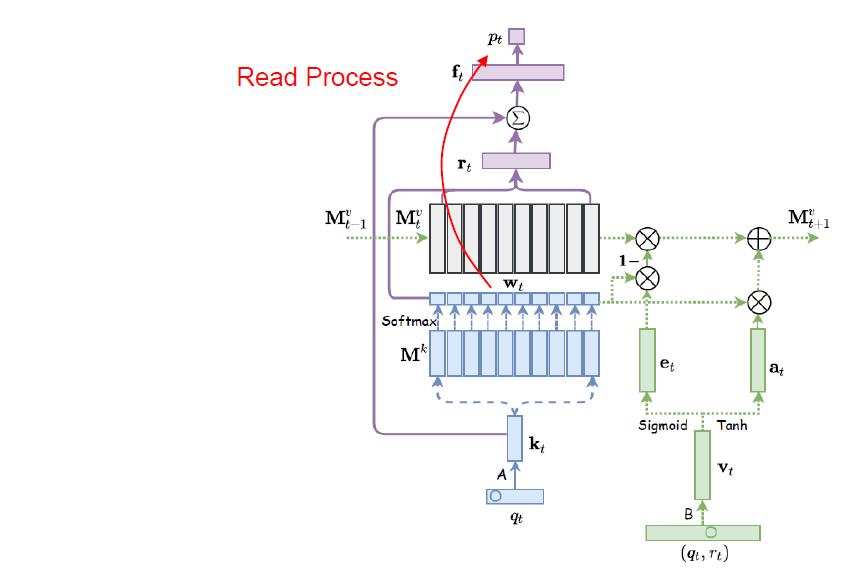
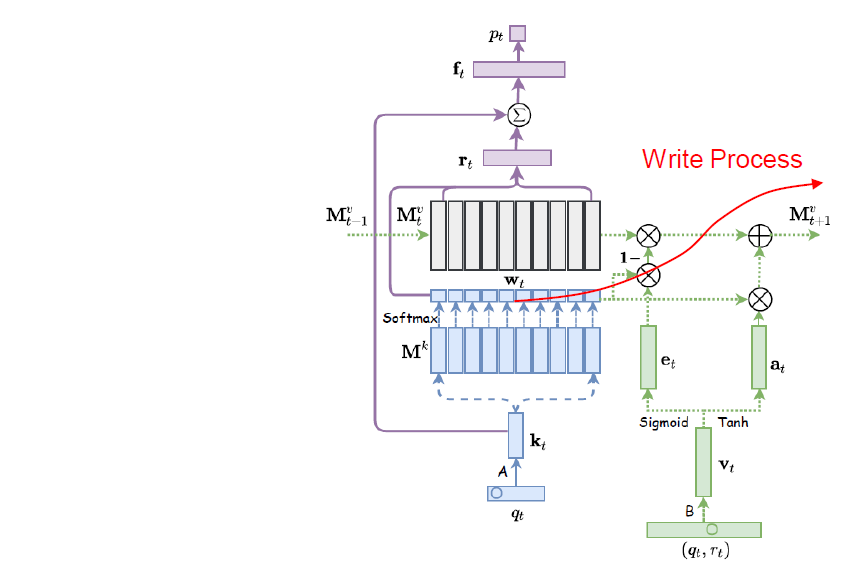
DKVMN 모델 추론은 크게 3단계로 구성된다. 먼저 Correlation Weight 계산, 그 다음으로 Read Process, 마지막으로 Write Process이다.

Correltation Weight
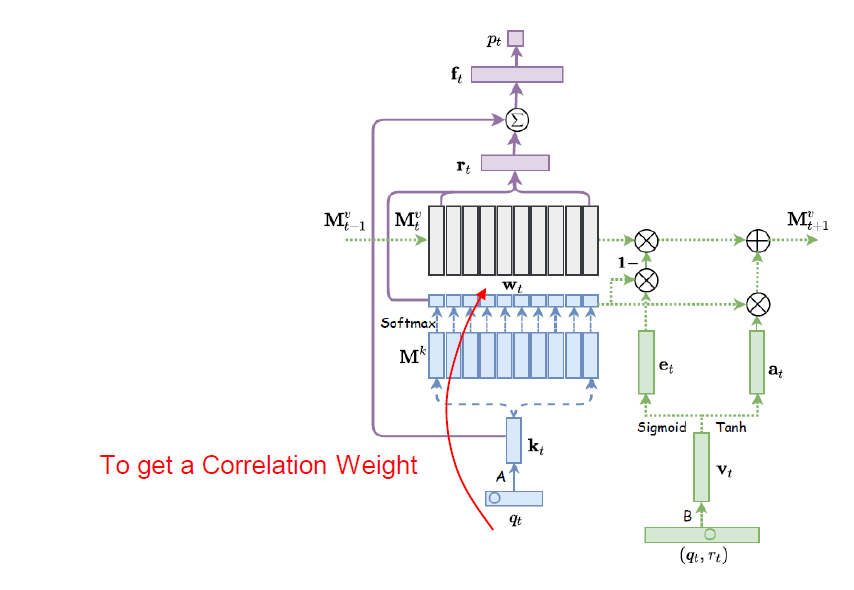
Correlation Weight 계산은 아래와 Attention Mechanism을 통해서 수행될 수 있다:

wt=Softmax(ktTMk)∈RN

즉, 문제 인덱스 qt의 임베딩 벡터인 kt와 Key Matrix Mk의 각 열벡터들과 Attention을 통해서 N개의 Latent Concept들 {c1,c2,⋯,cN} 각각과 유사도를 계산하고 Softmax를 통해서 정규화를 수행하여 Correlation Weight wt를 구하게 된다.

Read Process

위에서 결정된 Correlation Weight wt는 Value Matrix Mtv의 각 열벡터(사용자의 Concept State)들의 Weight Sum rt를 계산하는데 Weight로 사용되게 되며 이 의미는 현재 주어진 문제 qt에 대한 Response의 분포는 qt와 유사한 개념에 해당하는 사용자의 Concept State의 영향을 받을 것이라는 개념을 내포하고 있다.

rt=Mtvwt∈RN

이렇게 구해진 rt는 문제 임베딩 kt와 Concat되어 Fully-Connected Layer를 거쳐 ft를 계산하게 된다.

ft=Tanh(W1[rtT;ktT]T+b1)

이렇게 계산된 ft는 다시 Fully-Connected Layer를 거쳐 최종적으로 Response 분포 pt를 계산하게 된다.

pt=Softmax(W2ft+b2)∈RQ

여기서 Q는 전체 문제의 개수이다.

Write Process

Write Process는 사용자의 상호작용 (qt,rt)를 활용하여 현재 사용자의 Concept State를 업데이트하는 과정을 말한다.

Write Process는 Erase Vector et 및 Add Vector at를 먼저 구해서 Value Matrix를 업데이트하게 된다. Erase Vector 및 Add Vector를 구하기 위해서 먼저 상호작용을 vt로 임베딩하여 vt를 통해서 et 및 at를 구하게 된다.

et=σ(Evt+be)at=Tanh(Dvt+ba)

이렇게 구해진 Erase Vector 및 Add Vector를 통해서 Value Matrix는 다음과 같이 업데이트가 수행된다. 여기서 i에 대한 인덱싱은 i번째 열벡터를 의미한다.

M~t+1v(i)=Mtv(i)[1−wt(i)et]Mt+1v(i)=M~t+1v(i)+wt(i)at

여기서 wt를 활용하여 주어진 문제에 해당하는 Concept State의 업데이트를 더 강하게 수행하게끔 구현했다.

Training

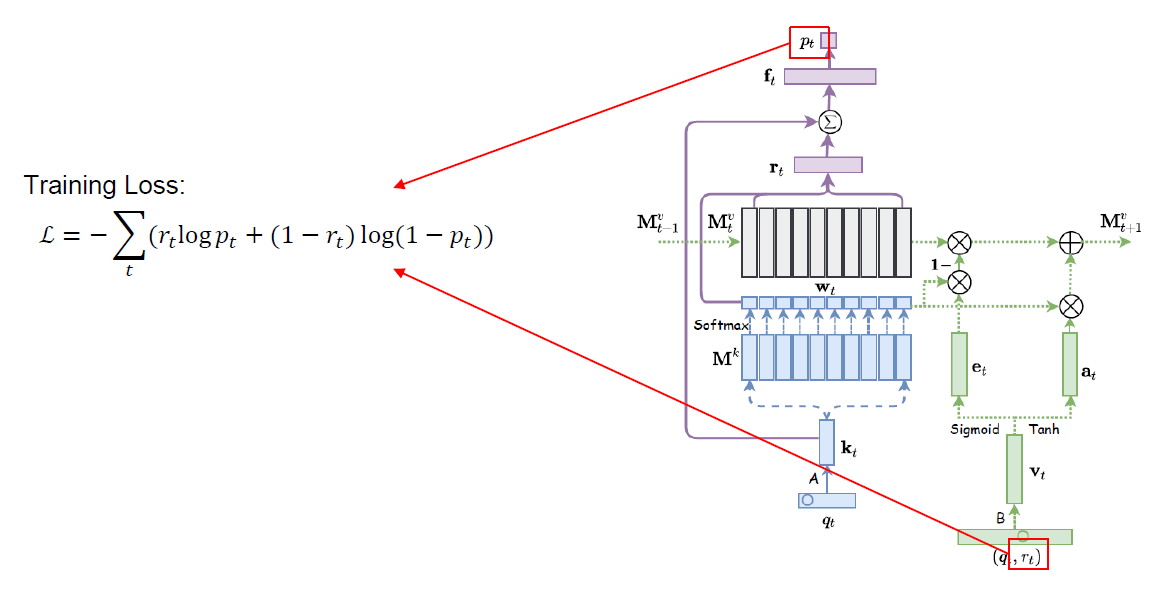
모델 학습은 위의 그림과 같이 주어진 문제 qt에 대한 Response 분포 예측 pt와 실제 Response 레이블 rt 사이의 Binary Cross Entropy Loss를 최소화하는 방식을 통해서 학습이 수행된다.

L=−∑t(rtlog⁡pt+(1−rt)log⁡(1−pt))

특히 DKVMN 모델은 모델 전체가 미분가능하기 때문에 Stochastic Gradient Descent를 통해서 학습이 수행될 수 있다. 모델 학습에는 모멘텀을 0.9로 두고 Stochastic Gradient Descent를 수행하였으며 Gradient에 대해서는 Norm 50을 기준으로 Clipping을 수행하였다. 모든 학습용 데이터는 시간 길이를 200단위로 잘라서 전처리를 수행하였으며 200보다 짧은 데이터는 Null 값으로 패딩을 수행하였다.

저자들은 특히 학습하는 과정에서 Key Matrix 및 Initial Value Matrix 역시 학습 가능한 파라미터로 설정하고 학습을 진행하였다고 강조하고 있으며, 테스트 과정에서는 Key Matrix는 고정하였고 Initial Value Matrix는 시간이 지남에 따라서 새로운 Value Matrix로 업데이트되게끔 설정하였다고 한다.

Prediction Performance

DKVMN은 기본적으로 성능 평가를 DKT와 비교하는 방식으로 수행하였다. 데이터셋은 총 4가지를 사용하였고 각각의 상세 정보는 다음과 같다.
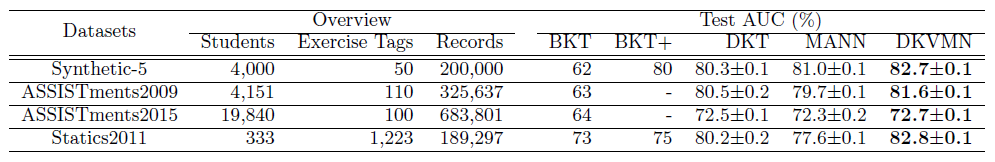
성능 평가는 DKT와 마찬가지로 AUC를 비교하는 방식으로 수행하였고 그 결과는 아래와 같다.
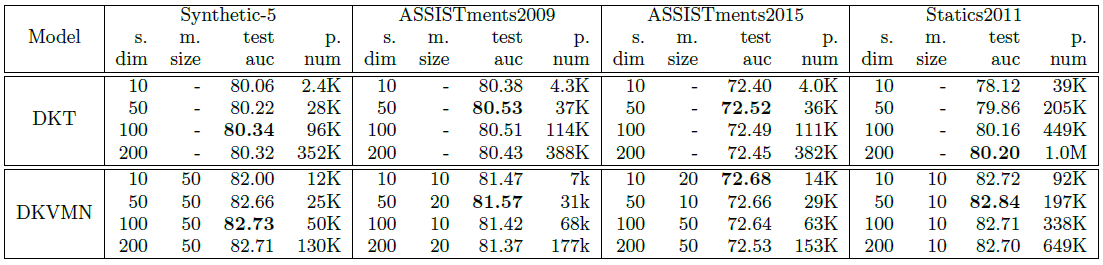
위의 결과를 통해서 저자들은 DKVMN이 DKT에 비해서 더 적은 파라미터를 가지고도 더 좋은 성능을 보인다고 주장한다.

이 부분에 대해서 개인적인 견해를 덧붙이자면, 딥러닝 모델을 모델링하는 경우 현재 모방하고자 하는 현실 모델에 대한 지식 또는 정보를 활용하여 딥러닝 모델링을 수행하는 경우에는 더 좋은 성능을 확보할 수 있다는 점을 이야기하고 싶다.

여기서 사용했던 현실 모델에 대한 지식은 모든 사용자마다 Concept State가 시간에 따른 Stochastic Process의 형태로 존재하며 각각 입력 피쳐에 대한 중간 피쳐들과의 인과관계를 최대한 활용하여 (특히, Read Process 및 Write Process에) 적용하였다는 점을 생각해볼 수 있겠다.

Concept Discovery

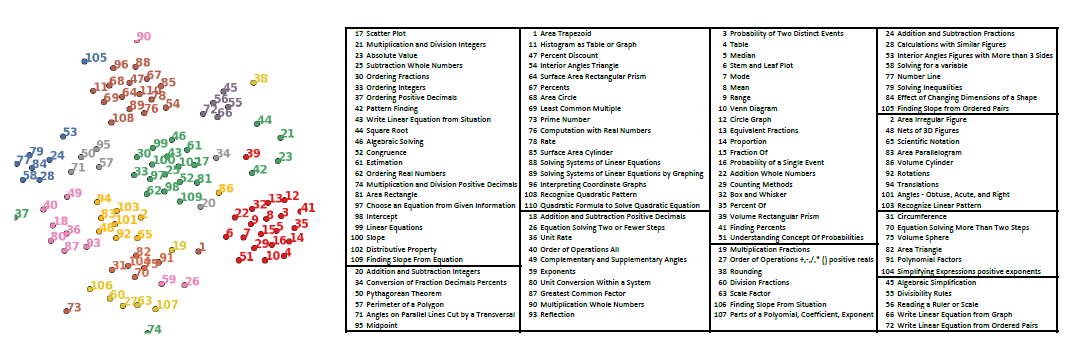
DKVMN 모델은 전문가의 태깅이 없이도 문제마다 내재된 개념을 찾아낼 수 있는 능력이 있다고 주장한다. 그 방법은 Correlation Weight를 이용하는 것인데 이 Correlation Weight이 가장 큰 개념에 해당하는 개념이 바로 주어진 문제에 해당하는 개념으로 결정되게 된다. 이러한 방식을 통해서 전문가가 태깅한 개념을 쉽게 찾아낼 수 있음을 아래 그림을 통해 보였다.
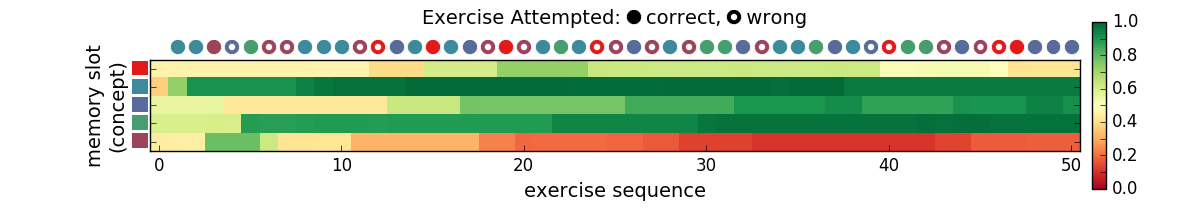
추가적으로 논문에서는 DKVMN의 사용자 Knowledge State를 확인하는 방법도 제시한다. 먼저 사용자의 i번째 개념에 대한 이해도를 확인하고 싶다면 먼저 Correlation Weight를 i번째의 값만을 1로 설정한 [0,⋯,wi,⋯,0],wi=1 형태의 One-Hot 벡터로 고정을 한다. 그 다음 Read Process를 통해서 먼저 rt를 구하게 된다. 이렇게 구해진 rt를 활용해서 ft를 구할때 문제에 대한 정보인 kt를 지워서 문제에 대한 정보를 무시한다.

ft=Tanh(W1[rtT;0T]T+b1)

이렇게 구해진 ft를 활용하여 Read Process를 끝까지 진행하고 Response Prediction pt를 구하면 이 pt가 사용자의 i번째 개념에 대한 이해도로 활용될 수 있다고 저자들은 주장한다. 아래 그림은 이렇게 구해진 사용자 Concept Discovery 결과이다. 시간에 따라서 5개의 개념에 대한 사용자의 이해도 값이 점차 변화한다는 것을 확인할 수 있다.

기타 참고 자료

수정 사항

  • 2021.04.17
    • 최초 게시

  1. 인공지능의 종류와 특징

    인공지능의 종류와 각각의 특징 인공지능(AI)은 좁은 인공지능(ANI), 일반 인공지능(AGI), 초인공지능(ASI), 머신러닝(ML), 딥러닝(DL)으로 나뉘며, 각각 특정 작업 최적화, 인간 수준 지능, 인간 초월 지능, 데이터 기반 학습, 인공 신경망 사용 등의 특징을 ...
    Date2025.03.03 Reply0 Views13 file
    Read More
  2. No Image

    엔비디아 H100 GPU 연산용 서버 조립, 2억 넘는 슈퍼컴퓨터

    #딥러닝#H100#GPU서버#워크스테이션#ai CPU: Intel Xeon Scalable Gold 6336Y (2EA) M/B: SUPERMICRO MBD-X12PI-NT RAM: SAMSUNG DDR4-3200 ECC/REG 768GB(64Gx12) SSD: SAMSUNG 980 PRO M.2 NVMe 2TB VGA: NVIDIA H100 80GB PCIE (4EA) CASE: 4U RACK Type Ra...
    Date2025.03.03 Reply0 Views20
    Read More
  3. 교육AI의 기본이자 시작 — Deep Knowledge Tracing(DKT)

    박준영(Jason Juneyoung Park) 님은 Riiid의 AI Research Lead 로 KT(정오답예측), SP(점수예측), RS(문제추천) 등 AIEd 연구를 리드하고 있습니다. 뤼이드 AI Research squad는 교육 AI 고도화를 위해 Knowledge tracing(KT), Score prediction(SP), Recommen...
    Date2024.10.13 Reply0 Views134 file
    Read More
  4. SAKT는 attention을 이용한 KT 모델로 정오 예측에서 과거 문제...

    SAKT는 attention을 이용한 KT 모델로 정오 예측에서 과거 문제 풀이 기록에 가중치를 주어 예측한다. SAKT는 아래 그림에서 e5​의 정오를 예측할 때, 연관된 knowledge concept을 가진 e2​,e4​에 높은 attention score를 준다. Datainteraction xt​=(et​,rt​)...
    Date2024.10.13 Reply0 Views1602 file
    Read More
  5. DKVMN (Dynamic Key-Value Memory Networks for Knowledge Trac...

    Knowledge TracingKnowledge Tracing이란 주어진 문제들을 풀어가는 사용자의 수준을 파악하기 위한 학습 모델을 추정하기 위한 태스크를 말한다. 기존 고전 방법론으로는 Bayesian Network 및 확률 모델 파라미터 추정 방법론들을 활용한 Bayesian Knowledge ...
    Date2024.10.13 Reply0 Views120 file
    Read More
  6. MLOps가 꼭 필요한 이유

    MLOps가 꼭 필요한 이유 엘리스 2023. 4. 26. MLOps(ML옵스)란 무엇일까요? 다소 생소한 용어지만 IT 업계에서는 종종 사용되고 있는 단어입니다. 최근 AI 활용 기술이 많아지면서 데이터 수집과 관리, 머신러닝 모델 개발 및 운영 등의 서비스를 효율적으로 ...
    Date2024.09.20 Reply0 Views166 file
    Read More
  7. 챗GPT 근간 ‘LLM’ 시대 갔나 새로 뜨는 ‘LAM’이 뭐기에

    챗GPT 근간 ‘LLM’ 시대 갔나 새로 뜨는 ‘LAM’이 뭐기에 2024-08-07 18:08:28 사진 확대 한 인터뷰가 인공지능(AI) 업계에 파장을 불러왔다. 주인공은 바로 세계 4대 인공지능 학자로 꼽히는 얀 르쿤 메타 AI최고과학자. 그는 5월 23일 파이낸셜타임스와의 인터...
    Date2024.08.07 Reply0 Views157 file
    Read More
  8. AI로 수명 예측·5분내 완충…‘新 배터리’ 온다

    AI로 수명 예측·5분내 완충…‘新 배터리’ 온다 발행일 : 2024-05-23 15:28 지면 : 2024-05-24 1면 배터리데이 2024 열려대표기업 집결, 차세대 로드맵 공개 SW·소재 혁신…기술 진화 이어져 전고체배터리 3년 뒤 상용화 주목 모든 전자기기의 심장 '배터리'가 새...
    Date2024.05.24 Reply0 Views221
    Read More
  9. OpenAI, 멀티모달 AI 모델, GPT-4 omni 공개

    오늘 2024년 5월 13일 현지시각(한국시간 2024년 5월 14일 새벽 2시), OpenAI에서는 스프링 제품 업데이트 라이브 스트리밍 이벤트를 진행했습니다. 이 자리에서 발표된 것이 바로 GPT-4o 입니다. GPT-4o는 기존 GPT-4 Turbo 모델의 성능을 넘어서는 동시에, ...
    Date2024.05.14 Reply0 Views289 file
    Read More
  10. 스탠포드대학, GPT-3.5급 구축 가능한 AI 모델 공개

    스탠포드대학, GPT-3.5급 구축 가능한 AI 모델 공개 스탠포드대학 연구팀이 메타 대규모 언어 모델인 LLaMA 7B 모델에 미세 조정을 실시한 오픈소스로 더 좋은 명령 추종성을 실현한 대규모 언어 모델인 알파카 7B(Alpaca 7B)를 공개했다. 알파카를 이용하면 G...
    Date2023.04.08 Reply0 Views281 file
    Read More
  11. ChatGPT,GPT(ChatGPT란?, GPT-3란?)

    ChatGPT,GPT(ChatGPT란?, GPT-3란?) 2023. 2. 8. 20:09 0. 들어가며 일론머스크가 공동창업자로 있었던 OpenAi에서 22년 11월 30일날 베타테스트를 시작한 ChatGPT가 연일 이슈입니다. GPT-3가 나왔을 때는 AI를 공부하던 사람들과 업계에서 큰 이슈가 되었다...
    Date2023.03.29 Reply0 Views156 file
    Read More
  12. Word Embedding Model Demo 테스트

    Word Embedding Model Demo http://nlp.kookmin.ac.kr/kcc/word2vec/demo
    Date2023.03.29 Reply0 Views320 file
    Read More
  13. AI 강화학습 - 인공지능 H 그네실험

    Date2023.03.29 Reply0 Views190 file
    Read More
  14. ‘빙(Bing) × 챗GPT’ AI 검색 사용방법! ‘chatGPT Plus’까지 바...

    ‘빙(Bing) × 챗GPT’ AI 검색 사용방법! ‘chatGPT Plus’까지 바로 직행하고 인공지능에 올라타세요 2023. 2. 22. 2:40 오늘 제 계정으로 마이크로소프트 빙(Bing) 사이트에 로그인하니 챗GPT 3.5가 결합된 '빙 AI'가 사용가능해진 것을 확인했습니다. AI 검색을...
    Date2023.03.26 Reply0 Views201
    Read More
  15. ‘언어를 넘어’ AI의 지평 넓히는 대규모 언어 모델 (LLM)

    ‘언어를 넘어’ AI의 지평 넓히는 대규모 언어 모델 (LLM) 자연어 처리를 뒤흔드는 초강력 모델들이 헬스케어와 로보틱스 등의 여러 분야에도 파문을 일으키고 있습니다. 2022.11.23. by NVIDIA KOREA 2018년에 BERT는 머신 러닝 모델들의 읽기와 말하기 학습을...
    Date2023.03.26 Reply0 Views156 file
    Read More
  16. No Image

    OpenAI의 API를 통해 Chat GPT-4 액세스하는 방법

    GPT-4 API에 액세스하는 방법은 무엇입니까? 상업적 용도로 GPT-4를 사용하려면 API 대기자 명단 에 이름을 올려야 합니다 . 자세히 보기 : GPT-3.5 대 GPT-4 – 지금까지 우리가 알고 있는 것은 다음과 같습니다. OpenAI는 다음과 같은 조용한 규정이 있지만 ...
    Date2023.03.19 Reply0 Views358
    Read More
  17. No Image

    ChatGPT-4 답변 테스트 : Write a thesis on the prospects of ...

    Q : Write a thesis on the prospects of the cloud Thesis Statement: Cloud computing has emerged as a game-changer in the world of technology and has the potential to revolutionize the way businesses operate. The prospects of cloud computing a...
    Date2023.03.19 Reply0 Views156
    Read More
  18. No Image

    아키텍트(Architect)의 종류와 역할

    아래는 1) Midjourney 2) Discord 3) 3-Vrew 를 이용하여, 생성한 동영상입니다. 아키텍트(Architect)의 종류와 역할 아키텍트란, 말 그대로 설계를 하는 사람입니다. 특히 IT 에서는 단기,중기 및 장기 비즈니스의 목표를 이루기 위한 다양한 IT 솔루션을 기...
    Date2023.03.19 Reply0 Views227 file
    Read More
  19. GPFS(General Parallel File System)

    GPFS(General Parallel File System) 클러스터 파일 시스템으로 불리우는 GPFS는고성능 공유 디스크 파일 시스템이라고 보시면 됩니다. 서비스 내용 GPFS는 클러스터 환경의 모든 노드에서 데이터에 액세스할 수 있도록 지원하는 고성능 공유 디스크 파일 시스...
    Date2020.08.27 Reply0 Views1824 file
    Read More
  20. No Image

    엔드포인트 보안에서 머신러닝의 역할

    시스코 코리아 공식 {=badgeName} 2018.10.04. 16:071,381 읽음 비밀글 통계 엔드포인트 보안이란 용어가 자주 들립니다. 엔드포인트(Endpoint)가 무엇이냐구요? 네트워크의 말단에 접속된 IT 기기라고 생각하면 됩니다. PC, 노트북, 서버용 컴퓨터와 같은 기...
    Date2019.07.26 Reply0 Views180
    Read More
목록
Board Pagination Prev 1 2 Next
/ 2