메뉴 건너뛰기

(*.155.195.240) 조회 수 320 추천 수 0 댓글 0
Atachment
첨부 '9'
?

단축키

Prev이전 문서

Next다음 문서

가 크게 작게 위로 아래로 댓글로 가기
Extra Form
출처 https://victorydntmd.tistory.com/308

1. Elasticsearch란?

Elasticsearch는 Apache Lucene( 아파치 루씬 ) 기반의 Java 오픈소스 분산 검색 엔진입니다.

Elasticsearch를 통해 루씬 라이브러리를 단독으로 사용할 수 있게 되었으며, 방대한 양의 데이터를 신속하게, 거의 실시간( NRT, Near Real Time )으로 저장, 검색, 분석할 수 있습니다.


Elasticsearch는 검색을 위해 단독으로 사용되기도 하며, ELK( Elasticsearch / Logstatsh / Kibana )스택으로 사용되기도 합니다.

ELK 스택이란 다음과 같습니다.

  • Logstash
    • 다양한 소스( DB, csv파일 등 )의 로그 또는 트랜잭션 데이터를 수집, 집계, 파싱하여 Elasticsearch로 전달
  • Elasticsearch
    • Logstash로부터 받은 데이터를 검색 및 집계를 하여 필요한 관심 있는 정보를 획득
  • Kibana
    • Elasticsearch의 빠른 검색을 통해 데이터를 시각화 및 모니터링
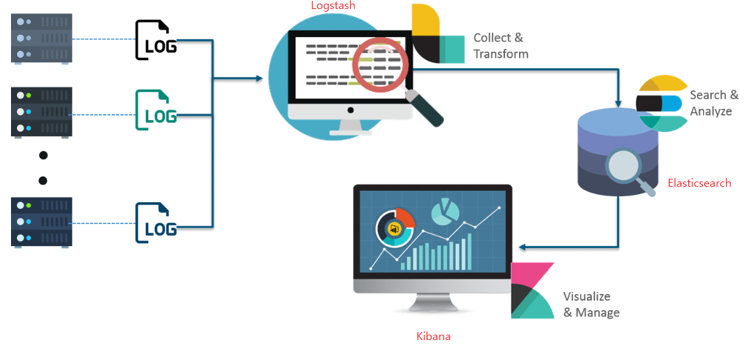
1.png

출처 : https://www.edureka.co/blog/elk-stack-tutorial/


이제부터 Elasticsearch와 관련된 용어와 특징들에 대해 알아보겠습니다.


2. Elasticsearch와 관계형 DB 비교
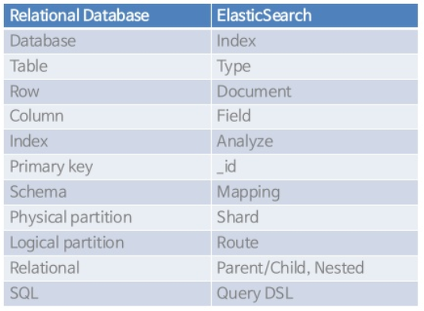
흔히 사용하고 있는 관계형 DB는 Elasticsearch에서 각각 다음과 같이 대응시킬 수 있습니다.

2.png

3.png

출처: https://www.slideshare.net/deview/2d1elasticsearch


RDBMS를 다루셨던 분들이라면 Elasticsearch에서 사용하는 용어들이 조금 낯설지만 예제를 몇 번 따라해보시면 금방 적응하실 것이라 생각됩니다.

그래도 용어가 낯설기 때문에 다음으로 용어 정리를 해보도록 하겠습니다.


3. Elasticsearch 아키텍쳐 / 용어 정리

Elasticsearch에서 사용하는 대부분의 개념은 RDBMS에도 존재하는 개념들입니다.

아래의 사진은 Elasticsearch Architecture이며, 앞으로 설명할 용어들의 구조입니다.
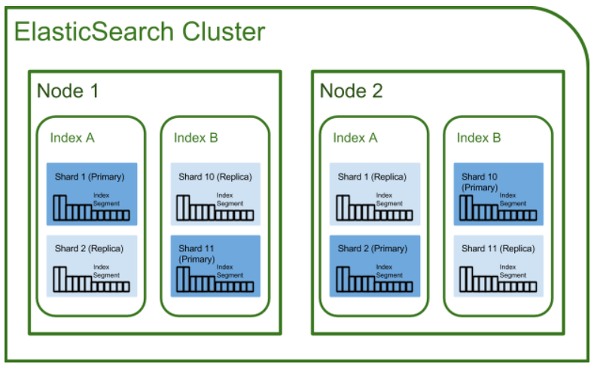
4.png

출처 : https://github.com/exo-archives/exo-es-search


1) 클러스터( cluseter )

클러스터란 Elasticsearch에서 가장 큰 시스템 단위를 의미하며, 최소 하나 이상의 노드로 이루어진 노드들의 집합입니다.

서로 다른 클러스터는 데이터의 접근, 교환을 할 수 없는 독립적인 시스템으로 유지되며,

여러 대의 서버가 하나의 클러스터를 구성할 수 있고, 한 서버에 여러 개의 클러스터가 존재할수도 있습니다.


2) 노드( node )

Elasticsearch를 구성하는 하나의 단위 프로세스를 의미합니다.

그 역할에 따라 Master-eligible, Data, Ingest, Tribe 노드로 구분할 수 있습니다.

아래는 각 노드들에 대한 설명인데, 제가 Elasticsearch에 대한 깊이가 없어서 공식 문서의 설명들을 정리만 해보았습니다.


master-eligible node ( 링크 )

클러스터를 제어하는 마스터로 선택할 수 있는 노드를 말합니다.

여기서 master 노드가 하는 역할은 다음과 같습니다.

  • 인덱스 생성, 삭제
  • 클러스더 노드들의 추적, 관리
  • 데이터 입력 시 어느 샤드에 할당할 것인지

Data node ( 링크 )

데이터와 관련된 CRUD 작업과 관련있는 노드입니다.

이 노드는 CPU, 메모리 등 자원을 많이 소모하므로 모니터링이 필요하며, master 노드와 분리되는 것이 좋습니다.


Ingest node ( 링크 )

데이터를 변환하는 등 사전 처리 파이프라인을 실행하는 역할을 합니다.


Coordination only node ( 링크 )

data node와 master-eligible node의 일을 대신하는 이 노드는 대규모 클러스터에서 큰 이점이 있습니다.

즉 로드밸런서와 비슷한 역할을 한다고 보시면 됩니다.


3) 인덱스( index ) / 샤드( Shard ) / 복제( Replica )

Elasticsearch에서 index는 RDBMS에서 database와 대응하는 개념입니다.

또한 shard와 replica는 Elasticsearch에만 존재하는 개념이 아니라, 분산 데이터베이스 시스템에도 존재하는 개념입니다.


샤딩( sharding )은 데이터를 분산해서 저장하는 방법을 의미합니다.

즉, Elasticsearch에서 스케일 아웃을 위해 index를 여러 shard로 쪼갠 것입니다.

기본적으로 1개가 존재하며, 검색 성능 향상을 위해 클러스터의 샤드 갯수를 조정하는 튜닝을 하기도 합니다.


replica는 또 다른 형태의 shard라고 할 수 있습니다.

노드를 손실했을 경우 데이터의 신뢰성을 위해 샤드들을 복제하는 것이죠.

따라서 replica는 서로 다른 노드에 존재할 것을 권장합니다.
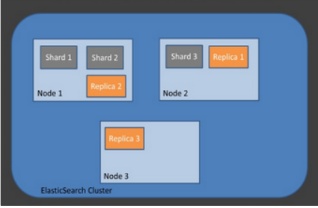
아래 사진에서 보는 바와 같이 Replica1은 Node2에 존재하는 것을 확인할 수 있습니다.

5.jpg

출처 : https://stackoverflow.com/questions/19838825/what-are-elasticsearch-indices#answer-19839840


4. Elasticsearch 특징
Elasticsearch는 다음과 같은 특징이 있습니다.
  • Scale out
    • 샤드를 통해 규모가 수평적으로 늘어날 수 있음
  • 고가용성
    • Replica를 통해 데이터의 안정성을 보장
  • Schema Free
    • Json 문서를 통해 데이터 검색을 수행하므로 스키마 개념이 없음
  • Restful
    • 데이터 CURD 작업은 HTTP RESTful API를 통해 수행하며, 각각 다음과 같이 대응합니다.
    • Data CRUD

       Elasticsearch Restful

       SELECT

       GET 

       INSERT 

      PUT

       UPDATE

      POST

       DELETE

       DELETE


5. 간단한 예제
Elasticsearch를 사용하는 간단한 예제를 다뤄보도록 하겠습니다.
이 예제는 RESTful API로 document를 추가하고 조회하는 예제이며, 맛보기용에 불과합니다.
이후의 글에서 자세히 알아보도록 하겠습니다.

Elasticsearch CRUD작업은 특징에서 살펴본 바와 같이 API를 호출해서 이루어지며,
curl로 데이터를 넘겨줄 수도 있지만, json 파일을 저장해서 데이터를 넘길 수도 있고, json 포맷으로 queryDSL을 작성해서 API를 호출할 수도 있습니다.

1) documnet 생성
# curl -XPOST 'localhost:9200/victolee/blog/1?pretty' -d '{"postName" : "elasticsearch", "category" : "IT"}' -H 'Content-Type: application/json'
  • -d 옵션
    • 추가할 데이터를 json 포맷으로 전달합니다.
  • -H 옵션
    • 헤더를 명시합니다. 예제에서는 json으로 전달하기 위해서 application/json으로 작성했습니다.
  • ?pretty
    • 결과를 예쁘게 보여주도록 요청

이렇게 curl 요청을 하면, victolee 인덱스에, blog 타입으로 id 값이 1인 document가 저장됩니다.
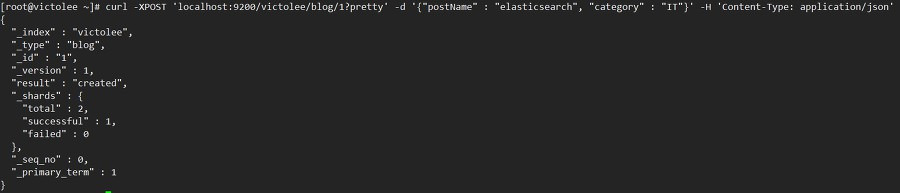
6.jpg


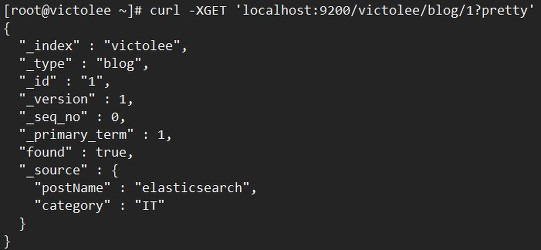
2) documnet 조회
# curl -XGET 'localhost:9200/victolee/blog/1?pretty'
document를 조회하는 API 입니다.

7.jpg

Elasticsearch를 잘 다루기 위해서는 Elasticsearch에서 제공하는 API를 알아둘 필요가 있으며,
queryDSL을 통해 쿼리를 작성해 원하는 방식대로 다양하게 조회할 수 있어야 합니다.

6. 역색인
그런데 Elasticsearch는 왜 빠를까요??
그 이유는 inverted index( 역색인 )에 있습니다.

먼저 index와 inverted index의 차이에 대해 알아보겠습니다.
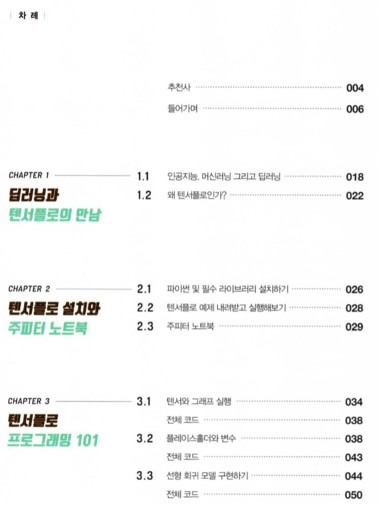
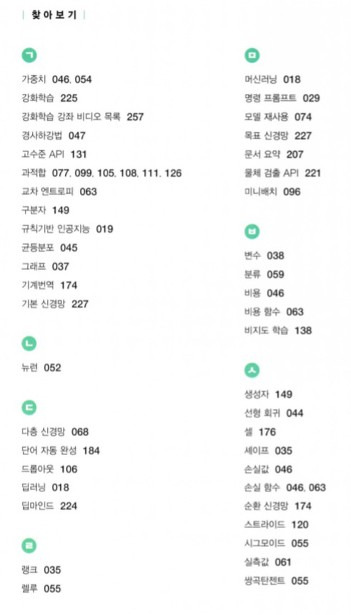
쉽게 말해서 책에서 맨 앞에 볼 수 있는 목차가 index이고,
책 맨 뒤에 키워드마다 찾아볼 수 있도록 찾아보기가 inverted index입니다.

8.jpg

[ Index( 색인 ) - 목차 ]

9.jpg

[ Reverted Index( 역색인 ) - 찾아보기 ]


Elasticsearch는 텍스트를 파싱해서 검색어 사전을 만든 다음에 inverted index 방식으로 텍스트를 저장합니다.

"Lorem Ipsum is simply dummy text of the printing and typesetting industry"
예를 들어, 이 문장을 모두 파싱해서 각 단어들( Lorem, Ipsum, is, simply .... )을 저장하고,
대문자는 소문자 처리하고, 유사어도 체크하고... 등의 작업을 통해 텍스트를 저장합니다.
때문에 RDBMS보다 전문검색( Full Text Search )에 빠른 성능을 보입니다.
( 참고 링크 - 9페이지 )


이상으로 Elasticsearch에 대한 개념잡기를 마치도록 하겠습니다.

Elasticsearch를 잘 다루기 위해서는 공식문서의 예제들을 따라해보는 것이 많은 도움이 될 것 같습니다.


  1. 테라폼(Terraform) - 개념, 장점, 관리툴

    ▶ IAC가상화 기술의 발전 Iac 란 Iac 종류 ▶ TerraformTerraform 개념 Terraform 장점 Terraform 구성 사용관리 툴 들어가기전에.. IT산업에 종사하면서 도구의 사용법을 익히는 것도 중요하지만, 그 뒷 배경 또한 중요합니다. 오늘은 IAC의 배경부터 관련 도...
    Date2024.10.01 Views246
    Read More
  2. Elasticsearch, Apache Lucene( 아파치 루씬 ) 기반의 Java 오...

    1. Elasticsearch란? Elasticsearch는 Apache Lucene( 아파치 루씬 ) 기반의 Java 오픈소스 분산 검색 엔진입니다. Elasticsearch를 통해 루씬 라이브러리를 단독으로 사용할 수 있게 되었으며, 방대한 양의 데이터를 신속하게, 거의 실시간( NRT, Near Real T...
    Date2024.09.22 Views320
    Read More
  3. Apache Nifi 의 구성요소, 아키텍쳐

    Nifi란?Apache Nifi는 시스템 간 데이터 전달을 효율적으로 처리, 관리, 모니터링 하기에 최적화 된 시스템임. 대량의 데이터 수집, 처리가능 Dataflow를 쉽게 구성이 가능하며, 시스템 간의 데이터 이동과 내용을 볼 수 있는 UI제공 강력한 자원과 권한 관리...
    Date2024.09.22 Views305
    Read More
  4. 아파치 카프카(Apache Kafka)는 분산형 스트리밍 플랫폼

    세계 최대 비즈니스 네트워크 사이트인 LinkedIn 은 하나의 서비스에 과도하게 많은 시스템이 연결되어 있어 서비스를 유지하고 관리하는데 어려움을 겪고 있다. 또한 시스템 유지 보수 및 서비스 관리에도 많은 부담이 가해졌다. 이를 극복하기 위해 컨플루언...
    Date2024.09.22 Views296
    Read More
  5. 쿠버네티스 시작하기 - Kubernetes

    docker logo 2013년 등장한 도커docker는 인프라 세계를 컨테이너container 세상으로 바꿔버렸습니다. 수많은 애플리케이션이 컨테이너로 배포되고 도커파일을 만들어 이미지를 빌드하고 컨테이너를 배포하는 게 흔한 개발 프로세스가 되었습니다. 2019년 Doc...
    Date2024.09.21 Views263
    Read More
  6. [NCP] VPC Peering

    VPC Peering에서는 인터넷 통신을 거치지 않고 비공인 IP를 통해 내부 네트워크로 다른 VPC와 통신하도록 구성할 수 있습니다. VPC Peering을 통해 전용 네트워크의 확장 효과를 누릴 수 있으며 안전한 통신이 가능합니다. 네이버 클라우드 플랫폼의 VPC 서비...
    Date2024.09.21 Views244
    Read More
  7. [AWS] VPC Peering

    VPC Peering VPC Peering 이란 다른 VPC간에 Private IP로 통신가능하도록 연결하는 것을 말합니다. 보통의 VPC 간 통신은 Public IP를 통해 이루어집니다. Public IP를 통해 통신을 할 경우 데이터의 안전성에 대한 문제가 발생할 수 있습니다. VPC Peering을...
    Date2024.09.21 Views246
    Read More
  8. No Image

    CIDR을 통해 알아보는 서브넷 마스크와 IP 클래스

    들어가며 가상호스팅 서비스를 이용하다보면 호스팅된 서버에 접근가능한 대역을 설정할 때 CIDR방식을 사용하라고 권장한다. 예) CIDR 0.0.0.0/0 이면 모든 대역을 의미한다. /(슬래시) 뒤에나오는 숫자의 의미는 뭔지, 특정 대역은 어떻게 표기하는지 궁금해...
    Date2024.09.21 Views245
    Read More
  9. 클라우드(Cloud) vs. 온프레미스(On-premise)

    클라우드(Cloud) 개념 '클라우드'란 '클라우드 컴퓨팅'의 약자이고, 인터넷을 통해 가상화 된 컴퓨터의 IT 리소스를 제공하는 것이다. 정보를 자신의 컴퓨터가 아닌 인터넷에 연결된 다른 컴퓨터로 처리하는 기술을 의미한다. * IT리소스는 흔히 컴퓨터의 성...
    Date2024.09.16 Views333
    Read More
  10. VPN(가상사설망) 프로토콜 비교 : SSL/L2TP/IPSec/PPTP

    VPN(Virtual Private Network) 가상 사설망 (출처) 위키백과 공중 네트워크를 통해 한 회사나 몇 몇 단체가 내용을 바깥 사람에게 드러내지 않고 통신할 목적으로 쓰이는 사설 통신망이다. 다시 설명하면 공중망에서 가상의 사설망을 구현하는 기술이라고 할 ...
    Date2024.09.16 Views250
    Read More
  11. [Spring Cloud] 스프링 클라우드 란 무엇인가요?

    스프링 클라우드(Spring Cloud)는 스프링 프레임워크 기반의 클라우드 네이티브 애플리케이션을 개발하기 위한 프로젝트입니다. 스프링 클라우드는 분산 시스템에서 필요한 다양한 기능들을 추상화하여 제공하고 있으며, 마이크로서비스 아키텍처를 구현할 때...
    Date2024.08.30 Views238
    Read More
  12. {개발자}로 자라기 – 쿠버네티스, 왜 배워야 할까?

    쿠버네티스, 들어본 적 있으신가요? 데브옵스(DevOps), 클라우드 분야에 관심 있는 분들이라면 한 번쯤 접해보신 경험 있으실 겁니다. 전 세계 다수의 대기업에서 이미 쿠버네티스로 시스템 기반을 전환했다고 하는데요. 560만 명의 개발자가 사용하고 있는 쿠...
    Date2024.08.30 Views281
    Read More
  13. 오토스케일링(Auto Scaling)이란? (AWS, 클라우드)

    1. 오토스케일링(Auto Scaling)이란AWS에서 Scale In / Out 기능을 자동으로 수행해주는 기능으로 정책에 따라서 자원을 조정해주는 AWS 서비스를 말한다. 스케일아웃(Scale Out)서버의 자원 스펙 상승으로는 한계가 있으며 효율이 떨어지는 시점이 있다. Scal...
    Date2024.07.09 Views213
    Read More
  14. Docker 이해하기 -2 : 컨테이너 라이프 사이클 & CLI 이해하기

    목차1) Docker 컨테이너 라이프 사이클 2) 컨테이너 라이프 사이클 단계 및 CLI 0. 요약 1. 컨테이너 생성 (Create Container) 2. 컨테이너 시작 (Start Container) 3. 컨테이너 실행 (Run Container) 4. 컨테이너 일시 정지 (Pause Container) 5. 컨테이너 재...
    Date2024.07.08 Views240
    Read More
  15. Docker 이해하기 -1 : 기초 이론(아키텍처, 흐름, 주요 용어)

    목차1) Docker 1. Docker 사용목적 2. VM(Virtual Machine)과 Docker의 차이 3. Docker 아키텍처 및 흐름 2) Docker 주요 용어 0. Docker 주요 용어 요약 1. 도커 클라이언트(Docker Client) 2. 도커 호스트(Docker Host) = 도커 서버(Docker Server) 3. 도커 ...
    Date2024.07.08 Views202
    Read More
  16. 정부원격근무서비스(GVPN)를 통한 통합운영관리시스템(nTOPS, n...

    정부원격근무서비스(GVPN)를 통한 통합운영관리시스템 (nTOPS, national Total Operation Platform System) 접속 "통합운영관리시스템"이란 표준운영절차의 이행을 지원하기 위한 정보시스템으로, nTOPS(national Total Operation Platform System)를 말한다. ...
    Date2024.06.14 Views470
    Read More
  17. 국가정보자원관리원(NIRS) G클라우드 소개

    국가정보자원관리원 G-클라우드 소개 대한민국 전자정부의 심장 역할을 수행하는 국가정보자원관리원(구, 정부통합전산센터)는 47개 중앙행정기관의 IT 인프라를 위탁 운영하는 행정안전부 산하기관으로 약 22,000개 SW와 24,000개 HW 정보자원의 효율적 운용...
    Date2024.06.14 Views399
    Read More
  18. RHEV 4.0 Hypervisor 설치 방법

    Red Hat 회사의 엔터프라이즈급 서버 가상화 제품인 RHEV 4.0 Hypervisor를 설치하는 방법에 대해 알아보도록 하겠습니다. 레드햇이 2008년에 가상화 업체였던 쿰라넷(Qumranet)을 인수하게 됩니다. 그리고 이때 KVM이 레드햇으로 넘어가게 되었죠. 다시 말해...
    Date2024.06.14 Views249
    Read More
  19. 클라우드에 'MSA' 적용이 필요한 이유

    빠른 개발과 다양한 요구사항에 대응하기 위해서 MSA를 적용하는 기업이 증가하고 있습니다. ​ ​ 특히, MSA는 클라우드 환경에서 시스템을 구축할 때 효율적인 측면이 많은데요. ​ ​ 떼려야 뗄 수 없는 클라우드와 MSA에 대해 알아보았습니다.​ MSA(Microserv...
    Date2024.05.29 Views306
    Read More
  20. No Image

    MSA (Micro Service Architecture)란?

    MSA란 그리고 등장 Monolithic Architecture 란? 소프트웨어의 모든 구성요소가 하나의 결합체를 이루고 있는 프로젝트 설계모습이 있다. 그런 설계 모습을 모놀리식 아키텍처라 부릅니다. 큰 규모의 서비스가 아니라면 모놀리식 아키텍처를 많이 사용하고 저...
    Date2024.03.15 Views250
    Read More
목록
Board Pagination Prev 1 2 3 4 Next
/ 4