

머신러닝과 딥러닝 차이
2016. 3. 17. 8:41
최근 구글의 알파고와 이세돌 9단의 대국이 많은 사람들의 관심을 끌고 있습니다. 구글의 알파고가 딥러닝(Deep Learning)으로 학습한 바둑 프로그램으로 알려지면서 딥러닝의 가능성에 대해 많은 기사가 쏟아져 나오고 있는 상황입니다. 이러한 현실에 발맞추어 오늘은 영상처리분야에서의 머신러닝 그리고 딥러닝에 대해 소개하도록 하겠습니다.
머신러닝과 딥러닝
안녕하세요 MATLAB & Simulink 사용자 여러분,
최근 구글의 알파고와 이세돌 9단의 대국이 많은 사람들의 관심을 끌고 있습니다. 구글의 알파고가 딥러닝(Deep Learning)으로 학습한 바둑 프로그램으로 알려지면서 딥러닝의 가능성에 대해 많은 기사가 쏟아져 나오고 있는 상황입니다. 이러한 현실에 발맞추어 오늘은 영상처리분야에서의 머신러닝 그리고 딥러닝에 대해 소개하도록 하겠습니다.
Machine Learning
Mitchell이라는 사람은 머신러닝에 대해 “작업 T를 수행하고 이에 대한 성능을 P로 측정한다고 했을 때, 경험 E를 통해 성능이 개선된다면 이 컴퓨터 프로그램은 학습한다고 할 수 있다”라고 정의했습니다. 영상처리분야로 위의 정의를 적용한다면 작업 T는 영상분류, P는 인식률 그리고 E는 학습집합이라고 할 수 있겠습니다.
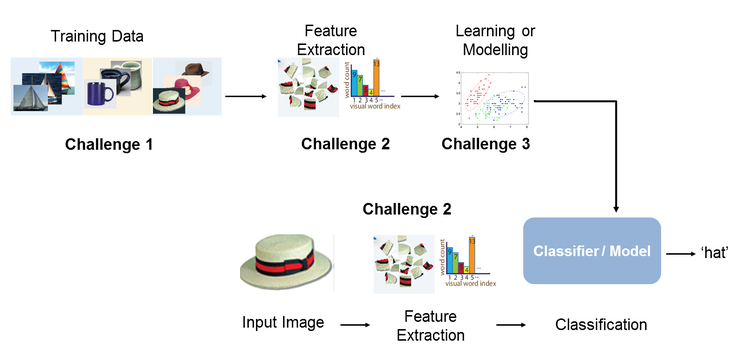
<그림 1. Machine Learning Workflow>
<그림 1>은 보트, 머그컵 그리고 모자를 분류하기 위한 머신러닝의 워크플로우를 나타낸 것입니다. 먼저 영상데이터를 학습에 사용할 것과 검증에 사용하기 위한 것으로 구분하고, 학습에 사용할 영상데이터에서 특징벡터를 추출해 냅니다. 이렇게 하면 입력 영상이 특징 공간에서 하나의 점으로 매핑이 되고, 훈련에 사용될 모든 영상에 대해 이러한 과정을 반복하면 특징 공간에는 훈련에 사용된 영상의 수만큼의 점들이 나타나게 될 것입니다. 그 다음으로 분류기(Classifier)를 학습시켜 특징공간을 3개의 영역 즉, 보트영역, 머그컵영역 그리고 모자영역으로 나누게 되는 것입니다. 지금까지의 설명이 머신러닝의 과정입니다. 그러면 다음으로 검증의 과정을 살펴보면, 검증을 위해 사용할 영상테이터에서 특징벡터를 추출하여 특징공간에 매핑을 해서 3개의 영역 중 어디에 속하는 지에 따라서 분류를 하게 되는 것입니다. 아래의 링크는 영상카테고리를 분류하는 예제로써 머신러닝의 전반적인 워크플로우를 이해하는데 도움이 될 것입니다.
Image Category Classification Using Bag of Features
Face Detection with Cascade Object Detector
머신러닝을 통해 사물을 검출한다면 가장 검출하고 싶은 것은 무엇일까요? 라는 질문을 던진다면 아마도 가장 많은 답변은 얼굴이 아닐까 합니다. 그래서 머신러닝의 예로써 얼굴 검출의 한 방법에 대해 조금 더 자세히 소개 할까 합니다.
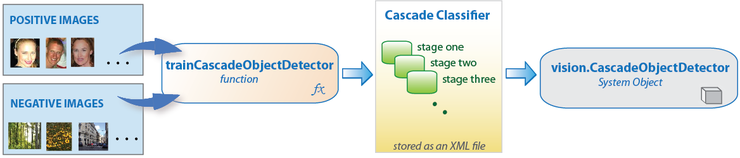
<그림 2. Cascade Object Detector Overview>
<그림 2>에서 보는 바와 같이 입력 영상은 사람의 얼굴이 포함된 Positive Image와 그렇지 않은 Negative Image를 사용하며 Positive Image에서 사람의 얼굴을 ROI(Region Of Interest)로 표시합니다. 다음으로 영상에서 특징벡터를 추출하는 작업을 수행해야 하는데, 사람의 얼굴의 특징을 추출하기 위해서 Haar-like feature나 LBP(Local Binary Patterns) 등이 사용될 수 있습니다. 그리고 분류기를 훈련시키는 작업이 이어지게 되는데 그림에 나타난 바와 같이 분류과정이 한 번에 이루어지는 것이 아니라 여러 단계를 거쳐 이루어지게 되어 있습니다. 조금 더 자세히 소개하자면 각 단계는 다수의 Weak Learner에 가중치를 곱하여 그 합으로 표현될 수 있으며 얼굴을 잘 검출해내는 것뿐만 아니라 얼굴이 아니어도 얼굴로 검출하는 것을 허용하게끔 학습 됩니다. 그 이유는 Cascade Object Detector는 다단계과정을 통해 분류작업을 수행하지만 검출의 시간을 줄이기 위해서 어느 단계에서든지 입력 영상에 얼굴이 없다고 판단되면 다음 단계로 넘어가지 않습니다. 결과적으로 검출의 정확도는 Detection Failure에 민감하게 반응하게 되며 따라서 Detection Failure의 발생을 최소화 하는 대신 False Alarm은 허용하도록 학습하는 것입니다. 그리고 False Alarm은 여러 단계를 거쳐 분류작업이 진행되면서 각 단계의 False Alarm확률이 f이고 s 단계가 적용된다고 가정하면 최종 False Alarm은  가 되어 False Alarm의 확률을 떨어뜨리는 것입니다.
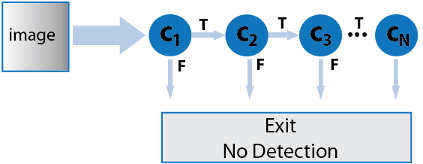
<그림 3. Cascade of Classifier>
Computer Vision System Toolbox는 사람의 얼굴, 상체, 눈, 코 등 검출의 수요가 높은 항목에 대해서는 머신러닝 통한 분류기가 함께 제공되기 때문에 함수에 검출하고자 하는 항목을 파라미터로 입력 받아 사용할 수 있습니다. 그리고 아래는 도로에서 Stop 표지판을 찾는 예제로 사용자가 직접 분류기를 만드는 과정의 예라 할 수 있습니다.
Training Cascade Object Detector 예제
Deep Learning
딥러닝은 2000년대 중반 SVM(Support Vector Machine)을 제치고 최고의 분류성능을 보이면서 현재까지 많은 사람들의 관심 속에 연구가 진행되어오고 있습니다. 딥러닝을 간단히 요약하자면 “Deep Neural Network의 각 Neuron을 연결하는 weight 값을 최적화하는 것이다”라고 정리할 수 있겠습니다.
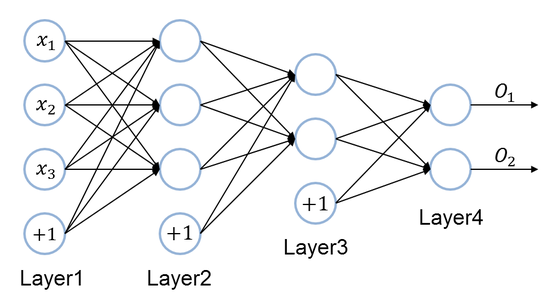
<그림 4. Deep Neural Network>
<그림 4>은 Neural Network의 구조를 나타낸 것으로 Layer 와 Layer 는 각각 Input Layer와 Output Layer이며 Layer 와 Layer 는 Hidden Layer가 됩니다. 입력 < ,
 ,
 >의 기대값(T)를 알고 있다면 Output Layer의 출력값(O)과의 차(T-O)를 계산하여 오류역전파(Backpropagation) 방법을 통해 그 차이를 최소화하는 방향으로 각 Neuron을 연결하는 weight값을 조정하는 것입니다.
그러면 머신러닝과 딥러닝의 차이점은 무엇일까요? 그 차이점은 바로 특징벡터의 추출 방법입니다. 앞의 머신러닝에 소개한 것처럼 머신러닝을 하기 위해서는 특징벡터를 추출해야 하며, 이는 사람이 정한 알고리즘에 기반한 것입니다. 예를 들면 LBP, SIFT, SURF등과 같이 말이죠. 반면 딥러닝은 특징점 추출과 분류기 학습이 함께 이루어집니다. 조금 더 자세히 얘기하자면 Deep Neural Network의 각 Layer의 Neuron은 특징벡터를 포함하게 됩니다. 다음으로 설명할 Autoencoder와 CNN(Convolutional Neural Network)이 이에 대한 이해를 도울 것입니다.
Autoencoder
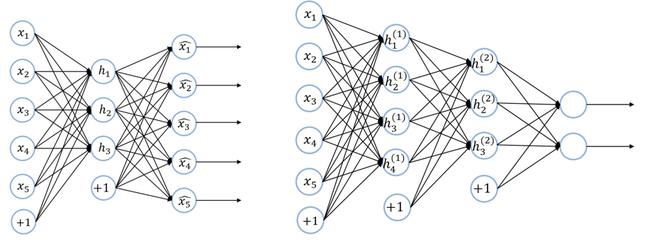
<그림 5. 5a-Autoencoder(left), 5b-Stacked Autoencoder(right)>
Autoencoder는 입력값과 출력값이 동일한 Neural Network입니다. <그림 5a>에서와 같이 입력벡터(I)가 Hidden Layer를 거쳐 출력벡터(O)으로 나타날 때 (I-O)의 차를 최소화하는 방향으로 Input Layer와 Hidden Layer의 사이의 weight 값을 조정합니다. 이때 Hidden Layer의 Neuron의 개수가 Input Layer의 Neuron의 개수에 비해 적으며 따라서 Hidden Layer의 Neuron은 입력에서 특징을 잘 나타내는 특징벡터가 저장될 수 있도록 학습을 하는 것입니다. 이러한 과정을 Layer별로 반복하여 누적하게 되면 <그림 5b>와 같이 Hidden Layer의 수가 2개 이상인 Deep Neural Network이 되며 각 Hidden Layer의 Neuron은 서로 다른 추상화레벨의 특징벡터가 저장됩니다. 마지막으로 지도학습(Supervised Learning), 즉 입력값에 대한 기대값(T)와 출력값(O)과의 차를 통해 오류역전파 방법으로 각 Weight 값에 대해 fine tuning을 수행합니다. <그림 6>는 Layer별로 비지도학습(Unsupervised Learning)을 하고 Layer를 누적하여 지도학습을 하는 과정을 MathWorks의 Neural Network Toolbox를 사용하여 진행한 결과입니다.
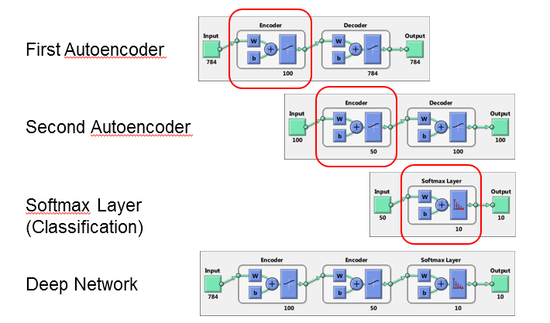
<그림 6. Stacked Autoencoder>
Training a Deep Neural Network for Digit Classification
CNN(Convolutional Neural Network>
CNN은 <그림 7>에 나타낸 바와 같이 특징을 추출하기 위해서 Convolution과 Pooling을 반복하는 것입니다. <그림 7>에서 특징을 추출하기 위해서 5x5의 크기를 갖는 다수개의 행렬이 사용됩니다. Convolution 이후의 feature map은 또다시 Convolution을 수행하거나 Pooling과정을 통해 2x2의 원소 중에서 평균 또는 최대값을 취하는 방식으로 feature map의 크기를 1/2로 줄여나갈 수 있습니다. 그리고 마지막 feature map과 Hidden Layer간에는 fully connected 방식으로 연결되며 이후 Softmax 단계에서는 오류역전파 방법을 통해 기대값과 출력값 간의 오차를 최소화 하는 방법으로 학습하여 fullconnect의 Neuron들을 연결하는 weight값과 Convolution Matrix 들의 원소값들을 최적화 하는 것입니다.
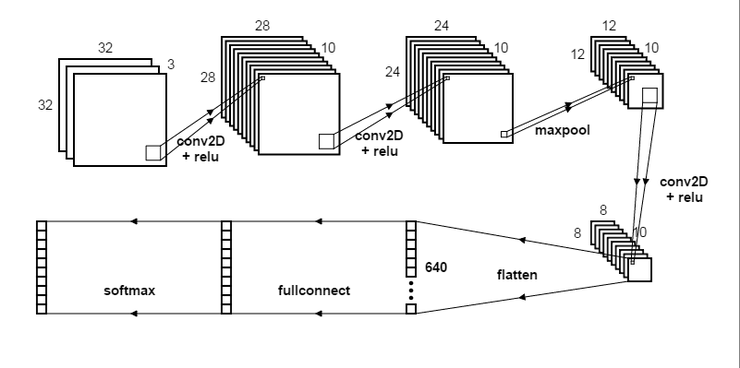
<그림 7. Convolutional Neural Network>
MathWorks에서는 Neural Network Toolbox 2016a 버전에서 CNN 기능이 제공되며 GPU를 활용한 병렬연산이 지원됩니다. 아래의 링크는 이에 대한 간단한 예제입니다.
아래의 링크를 통해 좀더 자세한 내용을 살펴보시길 추천합니다. 다음 포스트는 MATLAB과 C언어 간의 연동에 대해 기술하도록 하겠습니다.
추천링크
Deep Learning for Computer Vision with MATLAB(웨비나)
매스웍스코리아 홈페이지 바로가기 http://kr.mathworks.com/index.html?s_eid=PSM_11698