

[기업 탐방] IoT 시대 머신데이터 전용 DBMS ‘인피니플럭스’
바야흐로 인터넷 시대를 지나 모바일 시대로 진입하여 또 다른 IT 혁명이 진행되고 있다. 이 혁명의 중심에는 SNS와 클라우드 그리고, 이 모든 것을 합한 것 보다 더 큰 파괴력이 예상되는 IoT라는 거대한 물결이 눈앞에 있는 것이다.
이런 거대한 변화의 핵심은 정보의 흐름이고, 이는 필연적으로 데이터를 효율적으로 처리해야 하는 당연하지만, 소프트웨어 측면에서의 큰 도전이 존재한다. 그 이유는 이런 IoT 시대의 데이터는 이전 수십 년 전에 우리가 익숙히 보아왔던 시대의 것과는 사뭇 다르기 때문이다.
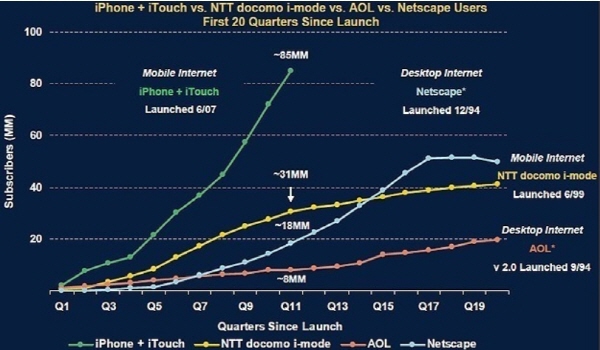
최근 데이터 발생 추이에 대한 보고 자료를 보면(그림1), 시간이 지날수록 데이터의 증가 속도가 기하급수적으로 증가한다. 그것도 지난 수십 년 동안 발생했던 데이터보다 최근 몇 년간의 데이터 발생량이 더 많을 뿐만 아니라, 이러한 속도가 가속화 될 것이라는 무시무시한 예측이 뒤따른다.
새로운 형태의 데이터 출현
전통적으로 IT 사용자들이 익숙하게 다뤄왔던 데이터는 흔히 말하는 데이터베이스를 통해 저장, 관리되는 “트랜잭션 형” 데이터이다. 쉽게 말해 인간의 삶과 밀접하게 연관되어 (예를 들어 우리의 이름이나 주소, 은행 거래 내역 등) 발생하며, 안정적으로 유지되고 관리되어야 하며, 비교적 빈번하게 수정이 되며, 그 데이터의 수효가 개략적으로 정해져 있거나, 증가하더라도 완만하게 증가한다.
또한, 이런 데이터들은 데이터의 중요도가 매우 높아서, 재난이나 IT 환경의 장애가 발생하더라도 안전하게 복구될 수 있도록 데이터를 보존하는 경우가 많다. 지난 수십 년 동안 이러한 형태의 데이터는 전통적인 데이터베이스라고 하는 영역에서 매우 잘 다루어왔으며, 앞으로도 영원히 잘 다루게 될 것임이 확실하다. 오늘 우리가 말하는 데이터베이스는 이러한 형태의 데이터를 가장 안전하고, 확실하게 저장하고, 처리하는데 최적화 되어 있는 소프트웨어 제품이다.
그런데, 새로운 형태의 데이터가 출현하기 시작했다.
기존에는 데이터의 발생이 주로 인간의 행동 혹은 요청에 의해 비교적 간헐적으로 발생했던 반면, 이제는 데이터의 발생이 IT 인프라 (혹은 머신: 컴퓨터, 센서, 네트워크 장비, 저장소 등)에서 기하급수적으로 발생하고 있는 것이다. 즉, 그 머신의 개수와 데이터가 시간이 지남에 따라 점점 더 많아지고, 결과적으로 데이터의 홍수를 이루는 지경에 다다르게 되었다. 최근 들어 미디어를 장식하는 “빅 데이터”의 상당부분이 바로 이러한 머신으로부터 생성되는 데이터 즉, “머신데이터”인 것이다.
이런 머신 데이터가 발생되는 산업 영역 다음과 같다.
모바일 단말 어플리케이션 및 클라우드 시스템
보안 및 네트워크 데이터 영역
금융보안 정보 및 금융 관련 거래 영역
전력 및 인프라 영역
게임 및 E-commerce 영역
기타 실시간 위험 탐지 및 방지 영역
IoT 시대의 머신 데이터 속성
이러한 머신 데이터는 기존의 트랜잭션 데이터와는 구별되는 몇 가지 특성을 가진다.
첫째, 데이터의 구조에 따른 시계열 특성이다.
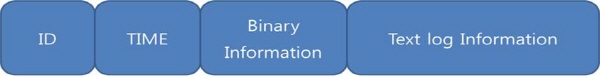
위의 그림에서 볼 수 있듯이 머신 데이터는 특정 머신의 고유 Identification이 반드시 포함된다.
그리고 그 머신의 상태, 예를 들어 온도, 습도, 가속도 등의 순간 정보를 보유한다. 마지막으로 눈으로 확인할 수 있는 텍스트 정보를 보유하고 있어서, 정규화 하기 힘든 데이터 형태를 문자열로 표현하도록 한다.
그러나 다른 데이터와 구별되는 가장 큰 속성은 시간이다. 다시 말해 데이터의 발생 시점과 데이터의 중요도가 서로 연관이 되어 있다는 뜻이며, 사용자 측면에서는 시간 축을 기준으로 머신 데이터에 대한 접근이 매우 빈번하다는 의미이다.
둘째, 데이터의 발생 속도이다. 적게는 초당 수만 건에서 많게는 수백만 건의 데이터가 하나 혹은 하나의 집단에서 발생한다. 이러한 데이터의 발생 속도는 기존의 전통적인 데이터베이스를 통해 데이터를 처리하는데 큰 장애가 되고 있다.
셋째, 실시간 처리 속성이다.
이 말은 데이터가 발생하는 순간과 그 데이터를 저장하고, 분석하는 시점이 거의 같은 시간이 이루어져야 한다는 것이다. 이는 머신 데이터의 활용 측면에서 “위험 방지 및 탐지”의 목적이 주된 것이기 때문이다. 중요한 외부 침입이나, 고가 장비의 장애에 대한 예방이나 감지가 한 시간 이후에나 가능하다면 이런 머신 데이터를 저장하고, 분석하는 목적은 단지 사후 처리에만 머물 것이다. 이 마지막 특성으로 인해 현재 전 세계적으로 수많은 파편화된 솔루션이 존재하고, 오늘도 새로운 기술들이 제시되고 있는 형편이다.
고난도의 머신 데이터 요구사항들
앞에서 언급한 바와 같이 머신 데이터의 발생과 더불어 사용자는 다음과 같은 요구사항을 지속적으로 원하고 있다.
머신 데이터의 데이터 저장
머신 데이터의 데이터 분석
저장 공간 효율화
지식 재활용 및 개발의 편의성
그러나 머신 데이터의 속성에 비추어보면, 위에 기술한 4가지의 요구사항이 결코 만만한 과제가 아님을 알 수 있다.
왜냐하면, 초당 수십만 이상의 데이터가 저장되어야 하는 요구사항과 그 데이터를 실시간으로 분석해야 하는 요구사항은 정확하게 상반되는 것이기 때문이고, 이를 기술적으로 해결하는 것은 새로운 혁신적인 기술적 진보를 의미하는 것이기 때문이다.
파편화된 솔루션들
결론적으로 오늘 현재 전 세계에 많은 머신 데이터 처리 솔루션들이 존재하며, 이러한 솔루션은 각각의 장단점이 존재한다.
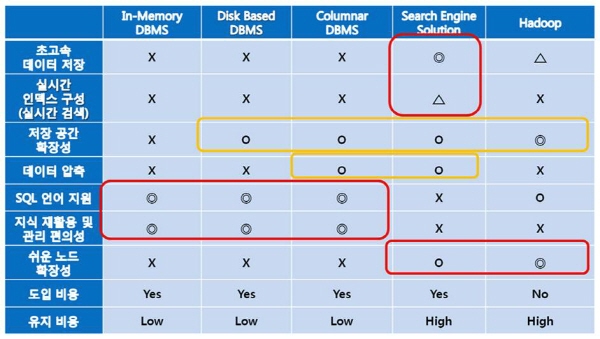
위의 그림에서 가로축은 현존하는 수많은 소프트웨어 솔루션을 나타내고, 세로축은 머신 데이터를 처리하는데 필요한 기능 요소이다. 그 중에서 빨간, 노란색 박스로 표현된 영역이 머신 데이터를 처리하는데 필요한 부분인데, 애석하게도 어느 한 솔루션도 모든 부분을 완전하게 커버하고 있지는 않는 것을 볼 수 있다.
그러나 가장 근접하게 기능을 제공하는 솔루션이 Search Engine 이라고 불리는 영역이다. 대표적으로 “splunk” 솔루션이 이 부분에서 많은 각광을 받고 있다. 그 이유는 우리가 부르는 머신 데이터는 “로그(log)”라는 형태로 파일로 존재하였고, 이러한 로그 파일을 검색하고, 처리하는 솔루션이 가장 먼저 머신 데이터를 처리하는 솔루션으로 채택이 되기 시작한 역사적인 배경이 있다.
Back to Basic
기업 환경에서 머신 데이터를 다시 한 번 고민해 보도록 하자. 기업이 추구하는 것은 효율성이며, 이는 비용에 대한 이야기다. 가정을 하자면, 기업 입장에서 가장 좋은 것은 기존에 도입한 솔루션 혹은 지식을 재활용하는 것이다. 좀 더 노골적으로 이야기하자면, 만일 “오라클” 혹은 “MSSQL”이 머신 데이터를 잘 저장하고 처리할 수 있다면 파편화된 솔루션이 있을 필요가 없었다는 것이다. 다시 말해서 “파편화된 솔루션”이 탄생된 배경은 기존의 데이터베이스가 이러한 데이터를 처리하지 못한다는 것이 가장 큰 원인이었다는 것을 알 수 있다.
질문을 바꿔보자.
만일 머신 데이터를 일반 데이터베이스 형태로 처리할 수 있다면 세상은 좀 더 좋아질 것인가?
그렇다면, 다음과 같은 몇 가지 장점이 존재할 것이다.
DBMS 관리 지식의 재활용
DBMS를 중심으로 한 에코 시스템의 재활용
응용 소프트웨어 개발의 편의성
사용편의성으로 인한 생산성 증가
즉, 머신 데이터(빅 데이터)가 별나라에서 온 특별한 것이라기보다는 기존에 하던 대로 데이터베이스로 처리할 수 있다는 가능성을 고객들에게 제시하는 것 그것이 또 하나의 기술적 진보를 이야기할 수 있다는 것이다.
인피니플럭스 (InfiniFlux) 개념
앞에서 기술한 바와 같이 인피니플럭스는 기존의 데이터베이스 기술을 활용하여, 머신 데이터를 보다 더 빠르고, 익숙하게 처리할 수 있도록 해 주는 새로운 형태의 디스크 기반 컬럼형 “데이터베이스”이다.
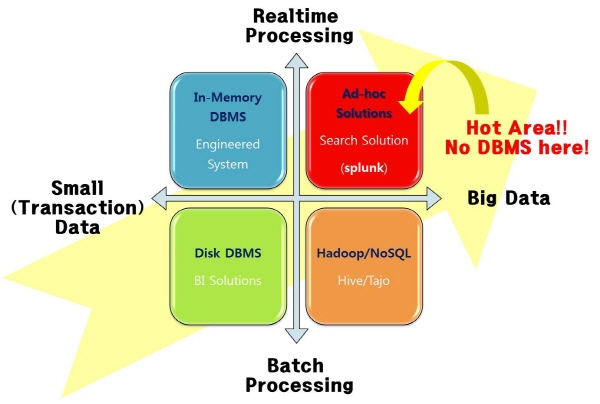
위의 그림에서 볼 수 있는 바와 같이 인피니 플럭스는 머신데이터(빅데이터) 영역에서 실시간으로 데이터를 저장하고, 처리할 수 있는 데이터베이스로서 포니셔닝을 하고 있으며, 이 부분은 전 세계 모든 솔루션 벤더들이 지향하는 지향점이기도 한다.
인피니 플럭스는 크게 3가지의 핵심 기술로 이루어져 있다.
 첫째, 컬럼형 데이터베이스 기술이다. 이 컬럼형이라는 것은 전통적으로 “매우 빠른 분석”을 의미한다. 레코드를 구성하는 컬럼을 별도의 영역에 모으는 것을 지향하기 때문에 통계분석에 특정 컬럼이 사용될 것을 수십에서 수백 배의 성능을 나타내기 때문이다. 이런 기술적 특성은 머신 데이터의 실시간 통계분석에서 잘 활용될 수 있다.
둘째, 메모리 기술이다. 머신 데이터는 초당 수십만에서 수백만 건의 데이터가 입력되는 시스템이기 때문에 1차적으로 모든 데이터를 메모리 공간에서 조작되어야 한다. 이 부분에서 실시간 데이터 저장을 위한 핵심 기술로 메모리 기술이 활용된다.
셋째는 실시간 검색엔진 기술이다. 현재까지 DBMS에서 실시간 검색이 지원되는 제품은 없었다. 그러나 특정 텍스트를 기준으로 검색하고, 이를 통해 특정 시간의 특정 이벤트를 검출하는데 핵심적인 기술이기 때문에 머신 데이터를 저장하는 솔루션은 반드시 제공되어야 한다. 인피니플럭스는 자체 내장된 실시간 인덱스 기술을 활용하여, 영문뿐만 아니라 한글 및 일본어, 중국어 까지 실시간으로 검색할 수 있는 고속의 인덱스 기술을 제공한다.
인피니플럭스(InfiniFlux) 와 전통 데이터베이스와의 차이점
인피니플럭스는 다음과 같은 특성에서 전통적인 DBMS와 큰 차별 점을 보인다.
트랜잭션 | Snapshot 기반 암묵적 제공 | Log File 기반 명시적 제공 | InfiniFlux에서는 트랜잭션 개념이 필요치 않음. |
Insert 성능 | 초당 30만~300만건 | 최대 1만건 | InfiniFlux는 입력 성능 향상을 위한 특별한 프로토콜을 지원 |
Select 성능 | 입력 및 통계 분석 질의에 최적화 | OLTP 처리에 최적화 | 컬럼형 데이터베이스는 통계 분석 질의에 최적화되어 있음. |
처리 데이터 속성 | 로그성 머신 데이터 | 비 로그성 트랜잭션 데이터 | InfiniFlux는 Insert의 경우 OLTP의 속성을 가지며, Select 연산은 OLAP 속성을 가짐. |
데이터 변경 모델 | Append Only | Updatable | InfiniFlux에는 변경연산을 지원 안함. |
Delete 연산 | 가장 오래된 것부터 삭제 | 임의의 데이터 삭제 | InfiniFlux는 append only 속성을 만족하기 위한 제약임. |
실시간 인덱스 | 실시간 비트맵 지원 | 비 실시간성 B+Tree | 초당 수백만건 가능 |
데이터 압축 | 고성능 실시간 압축 | 압축 지원 미비 | 컬럼형 데이터베이스의 경우 압축 지원 |
실시간 텍스트 검색 | 지원 (실시간 역인덱스 지원) | 미지원 (지원하더라도 실시간 속성 미비) |
|
시계열 데이터 지원 | Sharding을 통한 데이터 파티션 지원 | 일반 timestamp 컬럼 기반 지원 | InfiniFlux는 시간순으로 Sharding을 지원하기 때문에 시계열 기반 연산이 탁월하게 빠름. |
데이터와 인덱스 Gap | 0~30초 | Gap 발생하지 않음. | Insert 성능을 최대화 하기 위해 Insert 루틴과 인덱스 생성 루틴이 비동기로 동작함. |
MVCC 지원 | MVCC와 동일한 수준의 Locking 제공 | 지원 | InfiniFlux는 Lock을 최소화하였기에 이에 관련된 부하가 매우 낮음. |
개발 지원 라이브러리 | Interactive SQL, CLI, ODBC, JDBC 등 지원 | 지원 | InfiniFlux는 전통적인 데이터베이스의 개발 환경 그대로 지원함. |
특히, 붉은 색으로 표현된 것이 머신 데이터를 위한 인피니플럭스에서 부가적으로 제공하는 혁신적인 기능들이다.
마치며
지금까지 머신 데이터(빅데이터) 출현 배경과 관련 솔루션, 그리고 인피니플럭스가 왜 개발되었는지에 대한 개괄적인 설명을 하였다.
전 세계 IoT와 빅데이터(머신 데이터 포함)에 대한 관심이 매우 높아지고 있는 지금의 현실에서 전통적인 데이터베이스 지식을 그대로 활용할 수 있도록 해 주는 새로운 형태의 혁신적인 데이터베이스의 출현은 필연적이라고 하겠다.
특히, 향후 전 세계 수백 조 이상의 시장이 예상되는 IoT 시장에서 관련 머신 데이터를 고성능으로 손쉽게 저장하고, 처리할 수 있는 새로운 데이터베이스가 나온 것 그 자체로도 매우 큰 의미가 있다고 할 수 있다.
앞으로 인피니플럭스가 시장에서 어떻게 받아들여지고, 활용될 지 매우 기대가 되며, 큰 관심을 가지고 지켜보는 것도 흥미로울 것으로 보인다.
[김들풀 기자 itnews@itnews.or.kr]